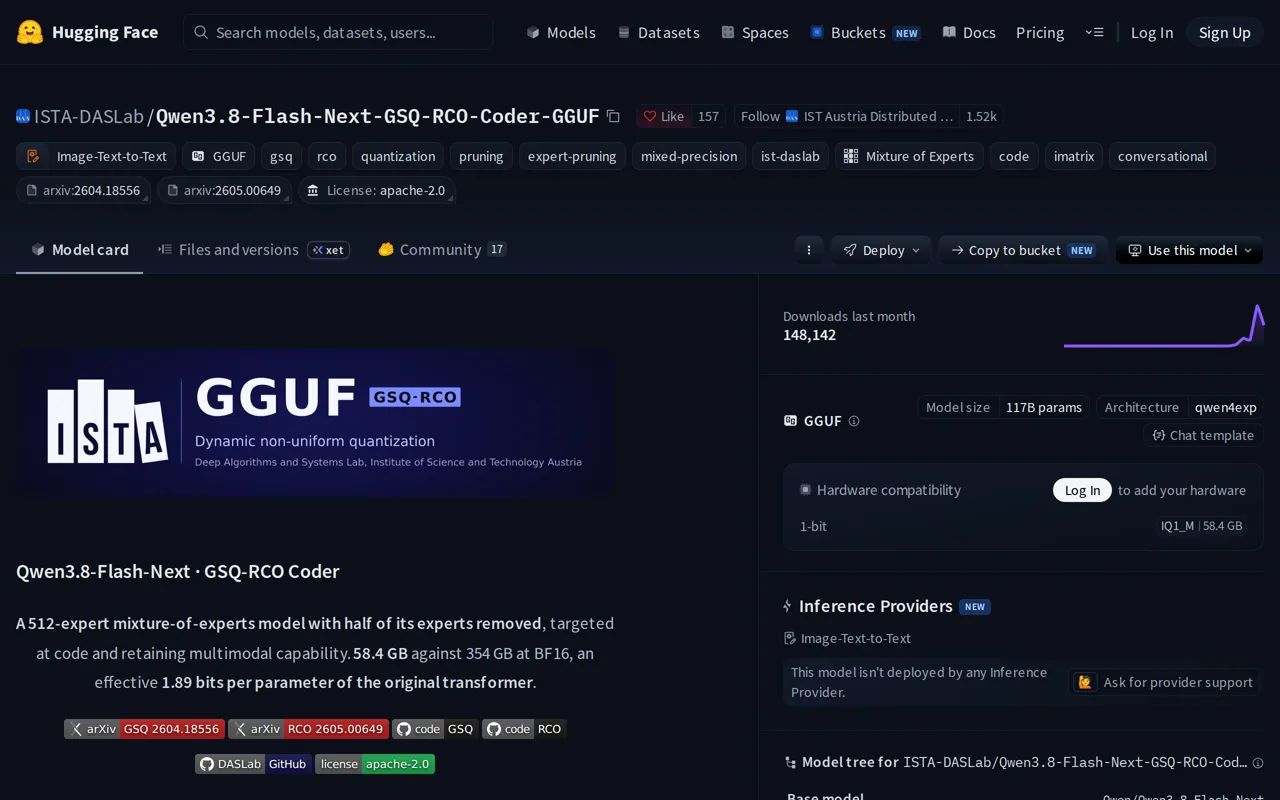
Qwen3.8-Flash-Next-GSQ-RCO-Coder-GGUF est une version compressée de Qwen3.8-Flash-Next, publiée par ISTA-DASLab. La moitié de ses experts a été retirée, en gardant ceux qui servent le code, les agents, la vision et le raisonnement spatial. Résultat : 58,4 Go au lieu de 354 Go, au prix assumé d’une baisse de qualité hors de ces domaines.
En bref
- 256 experts sur 512 par couche sont supprimés, les poids restants sont stockés à 3,5 bpw.
- 58,4 Go au total, dont 29,6 Go qui doivent résider en mémoire.
- 75,60 sur SWE-bench Verified (82,80 pour la base) et 86,28 sur LiveCodeBench v6 (87,43).
- Version expérimentale, déconseillée pour un usage général.
Un modèle de 354 Go ramené à 58,4 Go
Qwen3.8-Flash-Next compte 176,9 milliards de paramètres et occupe 354 Go en BF16, un format de nombres à 16 bits. Cette version est une compression ciblée : la moitié des experts routés est retirée du modèle, et les poids qui restent sont stockés à 3,5 bits par paramètre (bpw).
La fiche avance un taux effectif de 1,89 bit par paramètre du transformeur d’origine. C’est une moyenne qui répartit les experts supprimés sur le nombre de paramètres initial : aucun poids n’est réellement stocké à 1,89 bit.
Qu’est-ce que l’élagage d’experts ?
Un modèle MoE (mixture of experts, ou mélange d’experts) contient de nombreux blocs indépendants et un petit routeur qui en choisit quelques-uns pour chaque token. Flash-Next compte 512 experts par couche sur 48 couches, dont 10 actifs par token : les experts portent l’essentiel des paramètres, mais une fraction seulement travaille à chaque fois.
L’élagage supprime des experts entiers, alors que la quantification garde tous les paramètres et réduit la précision de leur stockage. Les deux techniques sont combinées ici. La question centrale est de savoir quels experts retirer : leur importance dépend des données de calibration, qui déterminent donc les capacités conservées.
Comment les experts sont choisis
La sélection repose sur RCO, une méthode d’optimisation sous contrainte de budget. Elle minimise la divergence KL (une mesure d’écart) entre le modèle élagué et le modèle complet sur les données de calibration, plutôt que de classer les experts avec un score heuristique.
Le format GGUF ne stocke qu’un seul nombre d’experts pour tout le modèle : chaque couche doit donc en garder autant. RCO impose un budget exact par couche, mais l’objectif reste global, car les couches sont optimisées ensemble. La quantification des poids restants vient de GSQ, une méthode de quantification post-entraînement compatible avec les types GGUF standards.
Que reste-t-il des performances ?
Tous les chiffres de la fiche sont mesurés à l’effort de raisonnement « xhigh ». Sur LiveCodeBench v6, le modèle obtient 86,28 contre 87,43 pour la base, soit 98,7 % conservés. Sur SWE-bench Verified, qui évalue de longues séquences d’actions sur de vrais dépôts de code, il obtient 75,60 contre 82,80, soit 91,3 %.
La fiche explique cet écart par l’accumulation d’erreurs sur les tâches à plusieurs étapes. Côté vision, une première recherche calibrée sur du code seul avait fait chuter les capacités d’image. La version publiée a été recherchée avec de la vision dans le mélange de calibration ; la vérification se limite à un test informel, un SVG de pélican à vélo.
Installer et essayer
Le modèle tient en deux fichiers, tous deux nécessaires. Le premier (29,6 Go) contient les poids du transformeur et doit résider en mémoire. Le second (28,8 Go) est une table de n-grammes en IQ4_NL (4,5 bpw), qui n’est ni élaguée ni optimisée et peut être lue depuis le disque. llama.cpp charge la paire quand on lui donne le premier fichier.
Voici les commandes de la fiche :
hf download <this-repo> --local-dir .
llama-cli -m IQ1_M/Qwen3.8-Flash-Next-GSQ-RCO-IQ1_M-00001-of-00002.gguf \
  -p "Refactor this function to be iterative." -ngl 99
Avant de se lancer
La fiche présente cette version comme expérimentale et reconnaît que les capacités hors code, agents, vision et raisonnement spatial se dégradent. Pour un usage général, elle renvoie vers les versions GSQ-RCO non élaguées. Les retours sont bienvenus, surtout sur les capacités absentes de la calibration.
Selon la fiche, 29,6 Go résidents tiennent sur un accélérateur de 32 Go. Elle cite aussi Strata, un moteur tiers, sans que ses affirmations soient vérifiées ici. Côté licence, les poids héritent de celle du modèle de base ; les métadonnées indiquent apache-2.0.
Questions fréquentes
Quelle mémoire faut-il ?
Seuls 29,6 Go doivent résider en mémoire, soit le premier fichier. Le second, de 28,8 Go, est une table de consultation qui peut être servie depuis le disque.
Ce modèle convient-il à un usage général ?
Non, la fiche indique que la dégradation hors code, agents, vision et raisonnement spatial est un coût accepté. Elle recommande les versions GSQ-RCO non élaguées pour cet usage.
Quelle différence entre élagage et quantification ?
La quantification garde tous les paramètres mais réduit la précision de leur stockage. L’élagage supprime des experts entiers, ce qui réduit aussi la mémoire nécessaire.
Faut-il les deux fichiers ?
Oui, les deux sont nécessaires. Il suffit de donner le premier à llama.cpp, qui charge la paire.
À retenir
Qwen3.8-Flash-Next-GSQ-RCO-Coder réduit un modèle de 354 Go à 58,4 Go en retirant la moitié de ses experts, avec 98,7 % du score LiveCodeBench v6 et 91,3 % de celui de SWE-bench Verified. Cette version expérimentale vise le code, et la fiche déconseille de s’en servir comme modèle généraliste.